
碳核算的規則之爭
碳核算的規則之爭從來不是技術問題,而是「核算邊界怎麼畫」的責任歸屬之爭;禹衡讓多口徑得以並排計算,把這個被壟斷的選擇攤開,但一把新尺子的公信力無法靠方法學嚴謹性自我證成,必須讓別人量過同一個東西、得到一致的結果。
磐石·禹衡大模型的技術突破、產業應用與方法學挑戰
一份從技術架構到企業執行的完整分析,兼論它對現行國際碳核算體系的衝擊與局限
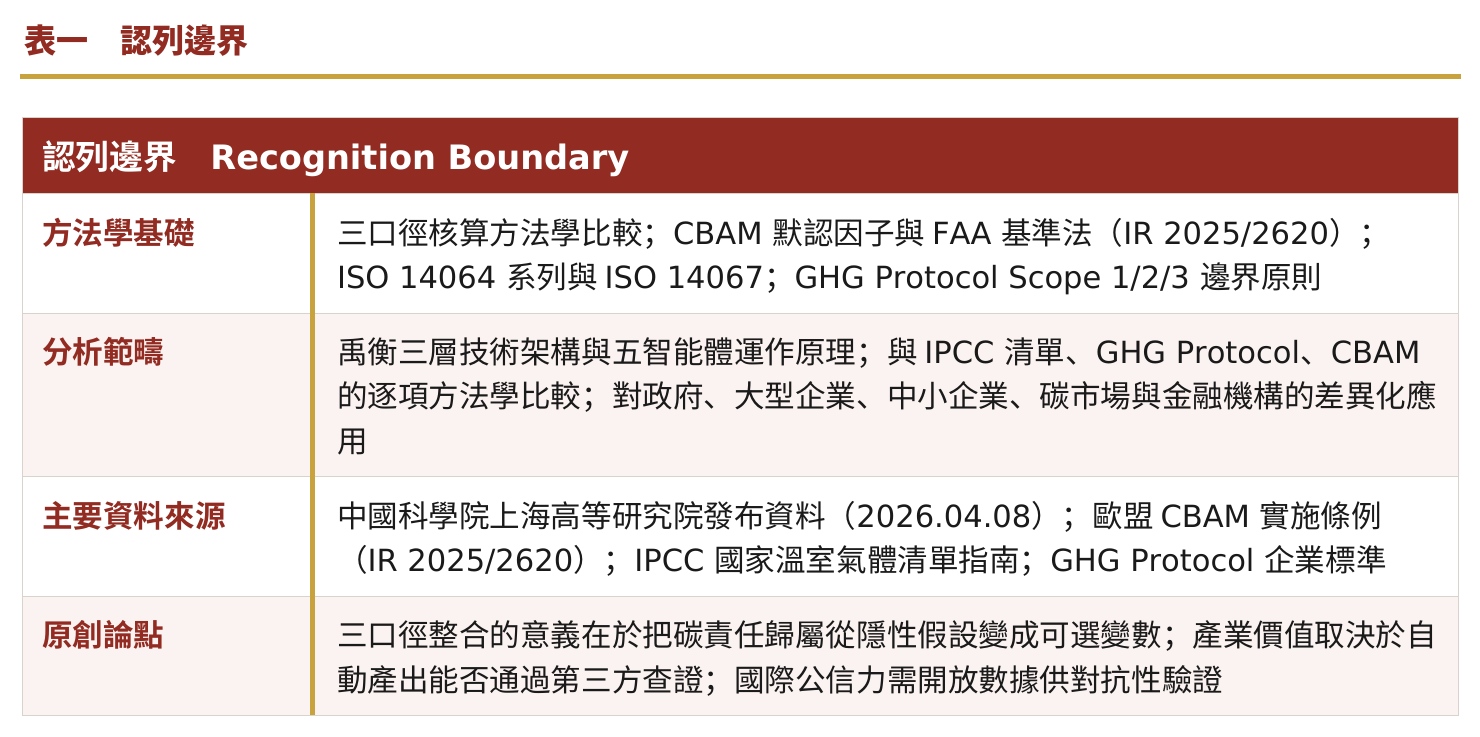
2022年,同一個地球,同一批碳排放,中國用生產端口徑算出的數字和用消費端口徑算出的數字相差17.7%,美國換算後上調15.2%,日本上調7.2%。這三個數字不是測量誤差。它們是方法學選擇本身造成的結果。碳核算領域最少被言明的一件事是這個。核算邊界怎麼畫,本身就是一個政治選擇,只是這個選擇過去三十年一直被當成技術預設,沒有被拿出來討論過。
2026年4月8日,中國科學院上海高等研究院發布「磐石·禹衡碳核算大模型」1.0版,定位為全球首個同時覆蓋生產端、消費端與自然源的全景式碳排放核算系統。技術規格是真的:累計匯聚208TB多格式碳數據,服務界面提供320億參數的垂直領域大語言模型,開發了五個具備特定功能的智能體。這篇報告要處理的問題有三個,複述規格不在其中。它在技術上究竟解決了什麼?產業要怎麼實際用它?它對現行國際碳核算體系構成什麼樣的挑戰,又有什麼樣的局限?
結論先講。禹衡真正的突破不在計算能力。它做的是另一件事:把「碳排放責任應該歸屬給誰」這個問題,從一個被隱藏的預設,變成一個可以切換的變數。這件事的產業影響、地緣政治影響,都比208TB這個數字大得多。
壹、核心主張
磐石·禹衡碳核算大模型真正的突破不在計算能力,而在它把「碳排放責任應該歸屬給誰」這個問題,從一個被隱藏三十年的技術預設,變成一個可以切換的變數。生產端與消費端口徑之所以能算出相差17.7%的結果,不是因為誰算錯,而是因為核算邊界怎麼畫本身就是一種責任分配的選擇。禹衡讓生產端、消費端與自然源三種口徑首次得以並排計算、互相校驗,把這個被生產端壟斷三十年的隱性選擇攤開成可討論的變數。但這套系統能否撼動現行國際碳核算秩序,取決於兩個它自己無法單方面決定的條件:企業端的自動核算產出能否通過第三方查證,以及它的方法學與數據能否開放供外部機構對抗性驗證。一把新的尺子,無法靠宣稱自己更準來建立公信,要等別人拿它量過同一個東西、得到一致的結果。
貳、技術架構:三層支撐體系如何運作
禹衡的根本設計目標,是通過生成式人工智慧重構碳核算的作業範式,動態刻畫全球碳流動與碳溯源。整體架構以中國科學院此前開發的「磐石·科學基礎大模型」為地基,往上疊加數據、算法、算力三層。理解這三層各自解決什麼問題,才能判斷這套系統的能力邊界在哪裡。
一、數據層:208TB 背後的五步鏈處理機制
數據層是整個模型的原料庫,採用內外部雙軌並行的建構策略,累計匯聚208TB多格式碳數據。這個數字要放在脈絡裡看。傳統碳核算的困境從來不是缺數據。工廠的能耗報表、海關的貿易數據、衛星的遙感影像、各國的排放因子資料庫,來源多、類型雜、更新頻率不一,格式與口徑全不相同,人工整合的成本高到讓精確核算變成少數大企業才玩得起的事。208TB 的價值不在容量。在治理。在它把這些格式全然不同的異質數據,做了一次統一的清洗與對齊。
內部數據集聚焦生產端、消費端、自然源、碳溯源等關鍵業務場景,外部數據集涵蓋法律法規、核算指南、行業知識及外部資料庫,合計八類自主數據集。這批原始數據要能被 AI 調用,必須先經過一條五步處理鏈:採集、清洗(去噪與去重)、治理(格式標準化與口徑統一)、向量化、結構化入庫。這條鏈的技術關鍵在向量化這一步,它把原本人類才讀得懂的法規文字、報表數字、圖像資料,轉成大語言模型能夠推理的嵌入向量,這是傳統資料庫做不到的,也是為什麼禹衡能用自然語言查詢碳數據,而傳統碳盤查軟體只能填表。
數據層還有一個容易被忽略的設計,是它透過與政府部門、行業機構的協同對接,實現數據高頻更新。這意味著禹衡是一個持續刷新的活資料庫,不會停留在某次訓練完成的那個時點。對碳核算來說這點很重要,因為排放因子、法規門檻、配額規則都在動,用兩年前的因子算今天的碳足跡,數字再精確也是錯的。
二、算法層:多口徑方法學為何是真正的技術難點
算法層是模型會思考的核心,包含兩個關鍵設計,多口徑碳核算方法學與多智能體協作架構。這兩者當中,前者才是禹衡最難、也最具原創性的部分。
傳統碳核算只有 IPCC 生產端的單一口徑。禹衡要同時支持生產端、消費端、貿易碳轉移、生命週期四種口徑,並讓它們互相協同對比,這在全球尚屬首次。難點在哪裡?難點在這裡。同一批底層數據,要能同時支撐四種邏輯完全不同的責任歸屬計算。四種口徑,四套邏輯,一個資料底座。生產端問的是「這個排放發生在哪裡」,消費端問的是「這個排放為誰而發生」,生命週期問的是「這個產品從搖籃到墳墓總共排了多少」。同一噸鋼的碳排放,在四種口徑下會被歸給四個不同的主體。要讓一套系統同時算出這四個答案,還要保持彼此一致,資料模型的複雜度遠高於任何單口徑系統。這是工程難題,不只是概念問題。
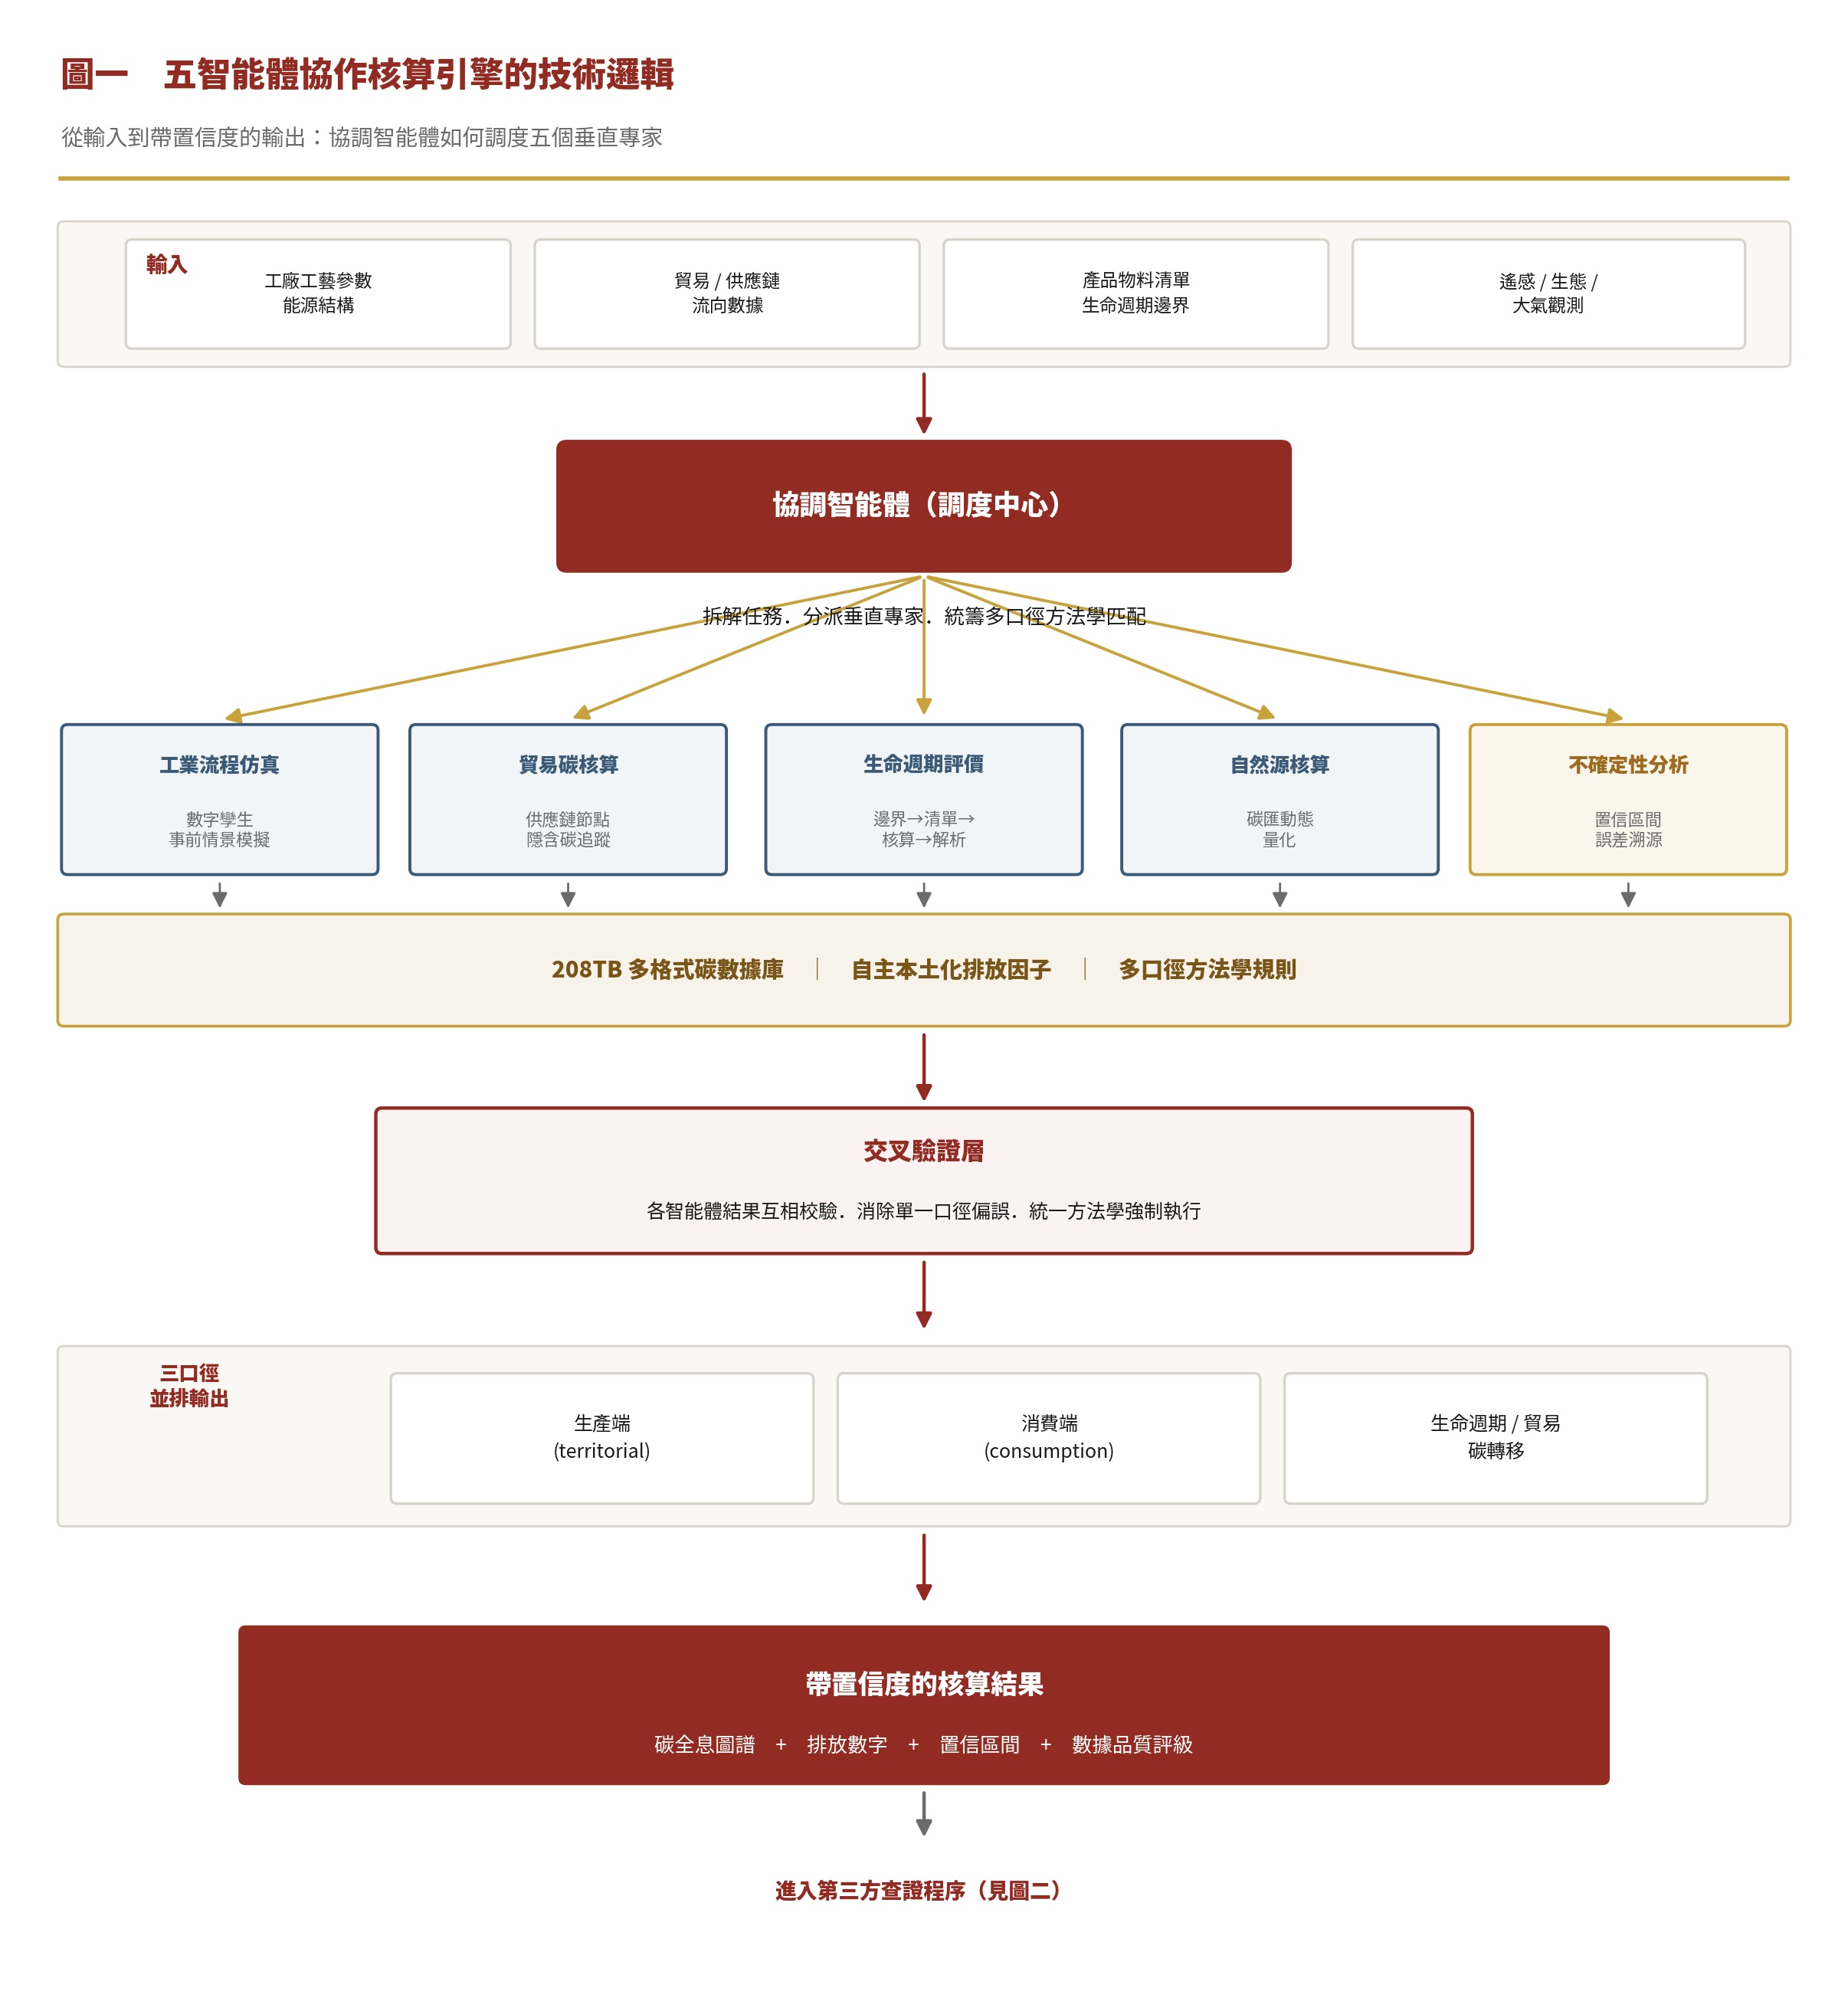
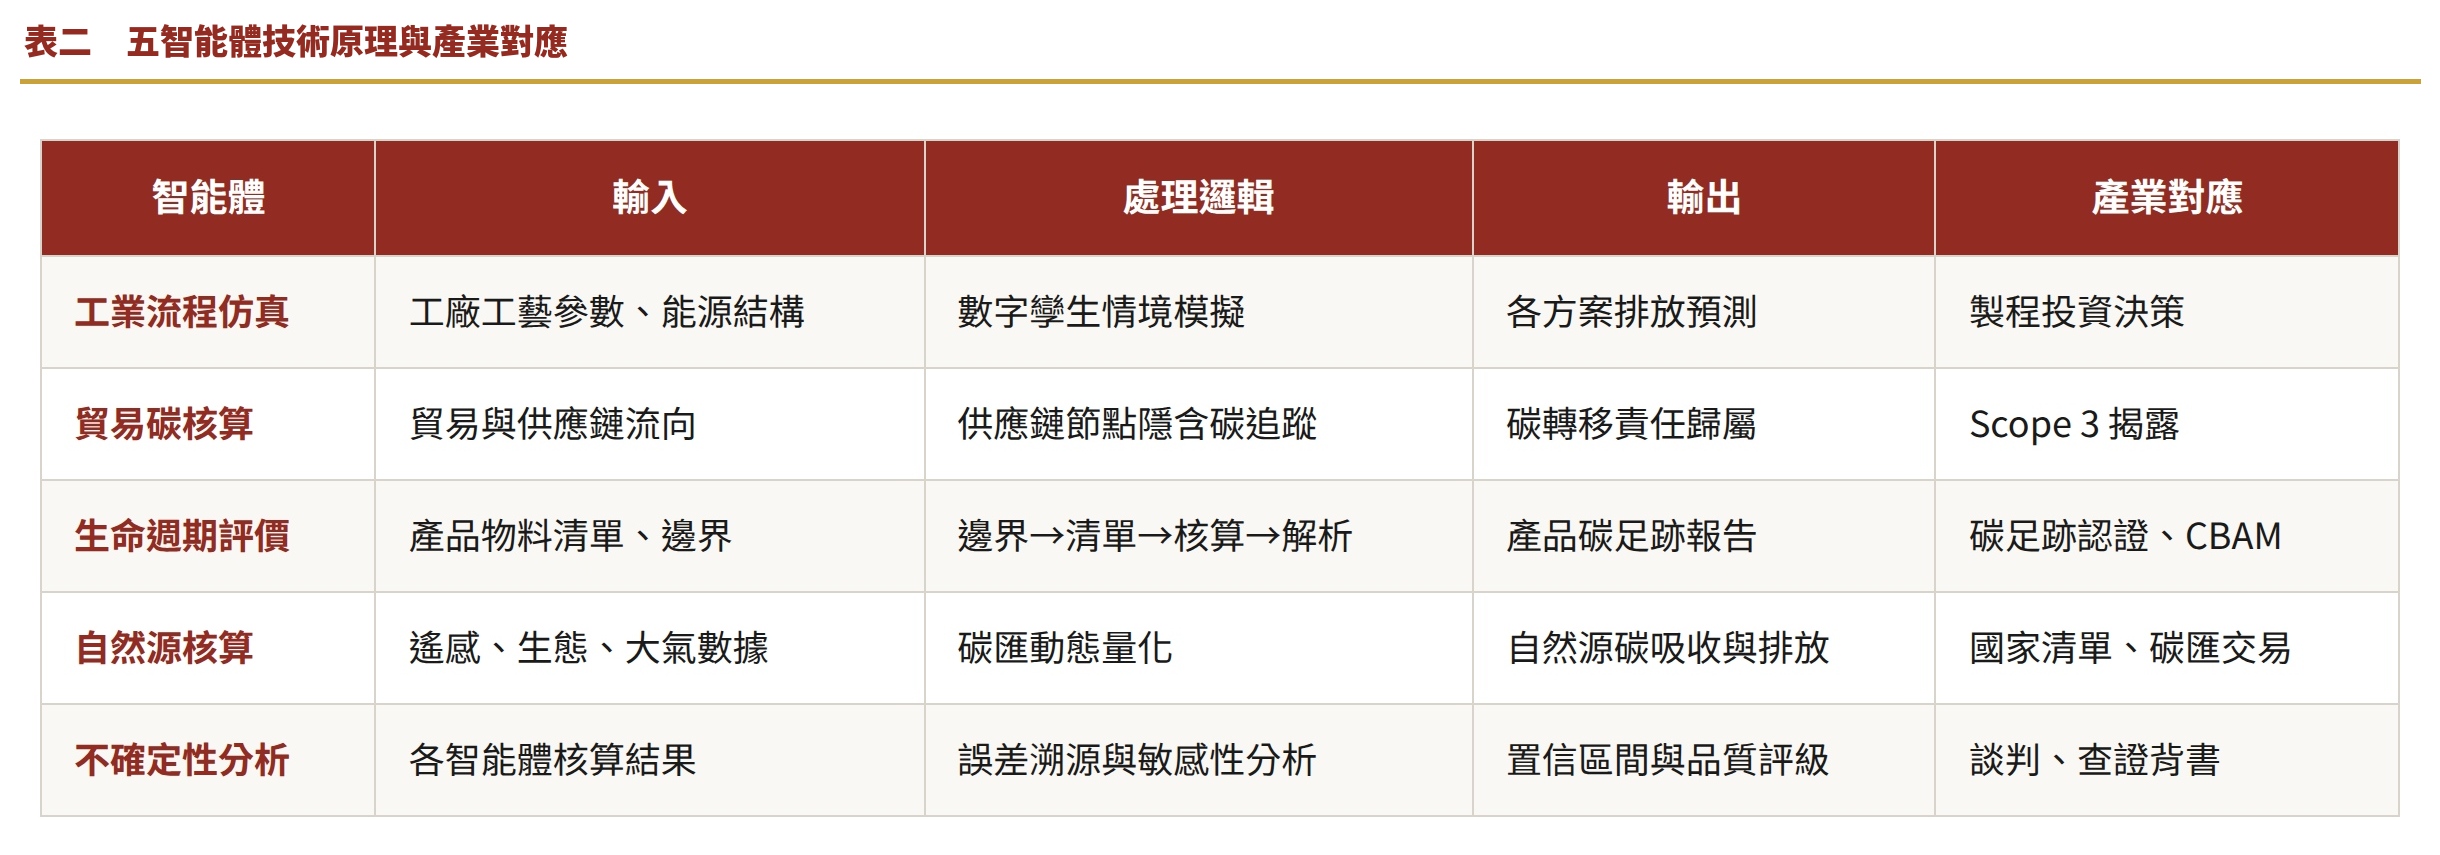
第二個設計是多智能體協作架構。它的運作邏輯類似專科醫生的會診制度,每個智能體是某個領域的垂直專家,面對複雜問題時由一個協調智能體統籌調度,讓各專科智能體分工協作、交叉驗證,最後整合出完整答案。這個架構相較於單一大模型端到端處理,在複雜場景下的核算精度更高,原因是碳核算牽涉的專業知識跨度太大,工業製程、國際貿易、生態科學、統計方法,硬要一個模型全包,反而每一項都做不精。把任務拆開,讓專家各管一段,再交叉驗證。這是用架構設計換精度。
三、算力層:混合架構的效率與數據安全權衡
算力層採用內部自有加外部雲端的混合架構,通過構建高性能內部服務器集群並與外部算力中心協同,實現算力資源的全局優化與彈性供給。這個設計的實質考量是兩件事的平衡。日常核算任務跑內部集群,速度快而且數據不出場,這對涉及企業商業機密與國家排放數據的碳核算尤其重要。遇到大規模模擬或批量國別計算時,再動態調配外部算力擴容。效率歸內部集群,安全歸數據不出場。兩者在這個架構裡是分層處理的。
參、五大智能體的技術原理與產業對應
禹衡的服務界面開發了五個具備特定功能的智能體。把它們理解成功能選單是誤讀。這五個智能體,各自對應碳核算領域一個長期被承認、卻始終沒被解決的操作瓶頸,每一個都有明確的輸入、處理邏輯與輸出。以下逐一拆解,並說明它對應的產業應用。
智能體一 工業流程仿真:把事後核算變成事前決策
傳統碳核算的根本限制是它永遠是事後統計。工廠這一季的排放,要等這一季結束、報表匯總之後才算得出來,此時任何調整都已來不及影響已經發生的排放。工業流程仿真智能體的突破,是把生產流程在數位環境中重建成數字孿生,模擬不同工藝路徑、原材料組合、能源結構下的碳排放量。輸入是工廠工藝參數與能源結構,輸出是各種假設情境下的排放預測。對鋼鐵、水泥、化工這類資本密集且減排路徑複雜的行業,這個智能體的產業價值最直接:企業在花錢改造產線之前,就能量化每一種方案的減排效果。
智能體二 貿易碳核算:Scope 3 最難的那一塊
跨國貿易隱含碳排放轉移的核算,追蹤的是供應鏈每一環節的隱含碳,這正是企業 Scope 3 揭露裡最難量化的部分。現行做法是向供應商逐層索取自報數據,越往上游,數據越稀薄、品質越不可控,而且缺乏系統性稽核手段。貿易碳核算智能體的處理邏輯是從貿易數據層直接建構碳流向,計算出哪個國家、哪家企業因為消費而真正承擔了多少碳責任,繞開了逐層蒐集的瓶頸。它對應的是供應鏈碳管理與國際碳責任重分配。消費端口徑真正發揮作用的地方,就在這裡。
智能體三 生命週期評價(LCA):自動化程度最高的一個
這是五個智能體裡自動化程度最高、也最可能直接改變產業實務的一個。它能自主完成目標與範圍確定、清單分析、核算、結果解析的全流程。傳統 LCA 需要專業工程師耗費數週手動填報數據、選取排放因子、界定邊界條件,LCA 智能體把這個流程壓縮到可以自動化完成。這裡有一個必須講清楚的分界:自動完成產出,跟這份產出能不能被第三方查證機構承認,是兩件不同的事。前者是效率問題,後者才是這份報告能不能拿去做 ISO 14067 認證、能不能用於 CBAM 申報的關鍵。自動化解決成本。查證解決效力。這是兩件事。
智能體四 自然源核算:補上被工業框架忽略的一塊
自然源核算智能體整合遙感衛星、生態模型與大氣觀測數據,對森林、海洋、土地等自然碳匯進行動態量化。自然源在傳統工業導向的核算框架裡長期是邊緣角色,森林吸碳、濕地排甲烷、海洋碳匯,這些非人為的碳流動要嘛被獨立處理、要嘛被忽略。這個智能體的意義,是讓碳帳本真正覆蓋完整的地球碳循環,而不只是人為活動的部分。對國家清單編制與碳匯交易來說,這塊拼圖不能缺。
智能體五 不確定性分析:讓系統知道自己有多可靠
這是整個系統的後設層。任何核算都存在數據缺失、方法選擇差異、假設條件不同帶來的不確定性,這個智能體對每一份核算結果標注置信區間、誤差來源與敏感性分析。在國際氣候談判與商業查驗的語境裡,「我們算出這個數字」和「我們算出這個數字,誤差範圍在此,主要不確定性來自這裡」,是說服力層次完全不同的兩種主張。這個智能體的存在,是禹衡能不能被當成嚴肅科學工具、而不只是宣傳計算器的分野。
肆、產業如何實際導入:從需求到可查證輸出
理解技術架構之後,真正的問題是企業要怎麼把它用起來。禹衡透過兩大接口層對外提供服務,對話接口供不具技術背景的管理層與政策研究者用自然語言查詢,編程接口 API 供開發者與企業系統整合、支持批量核算與自動化報告,此外也允許針對特定場景單獨調用某一智能體。但接入方式只是第一步,實際的執行流程會依企業規模分流,走出完全不同的路徑。
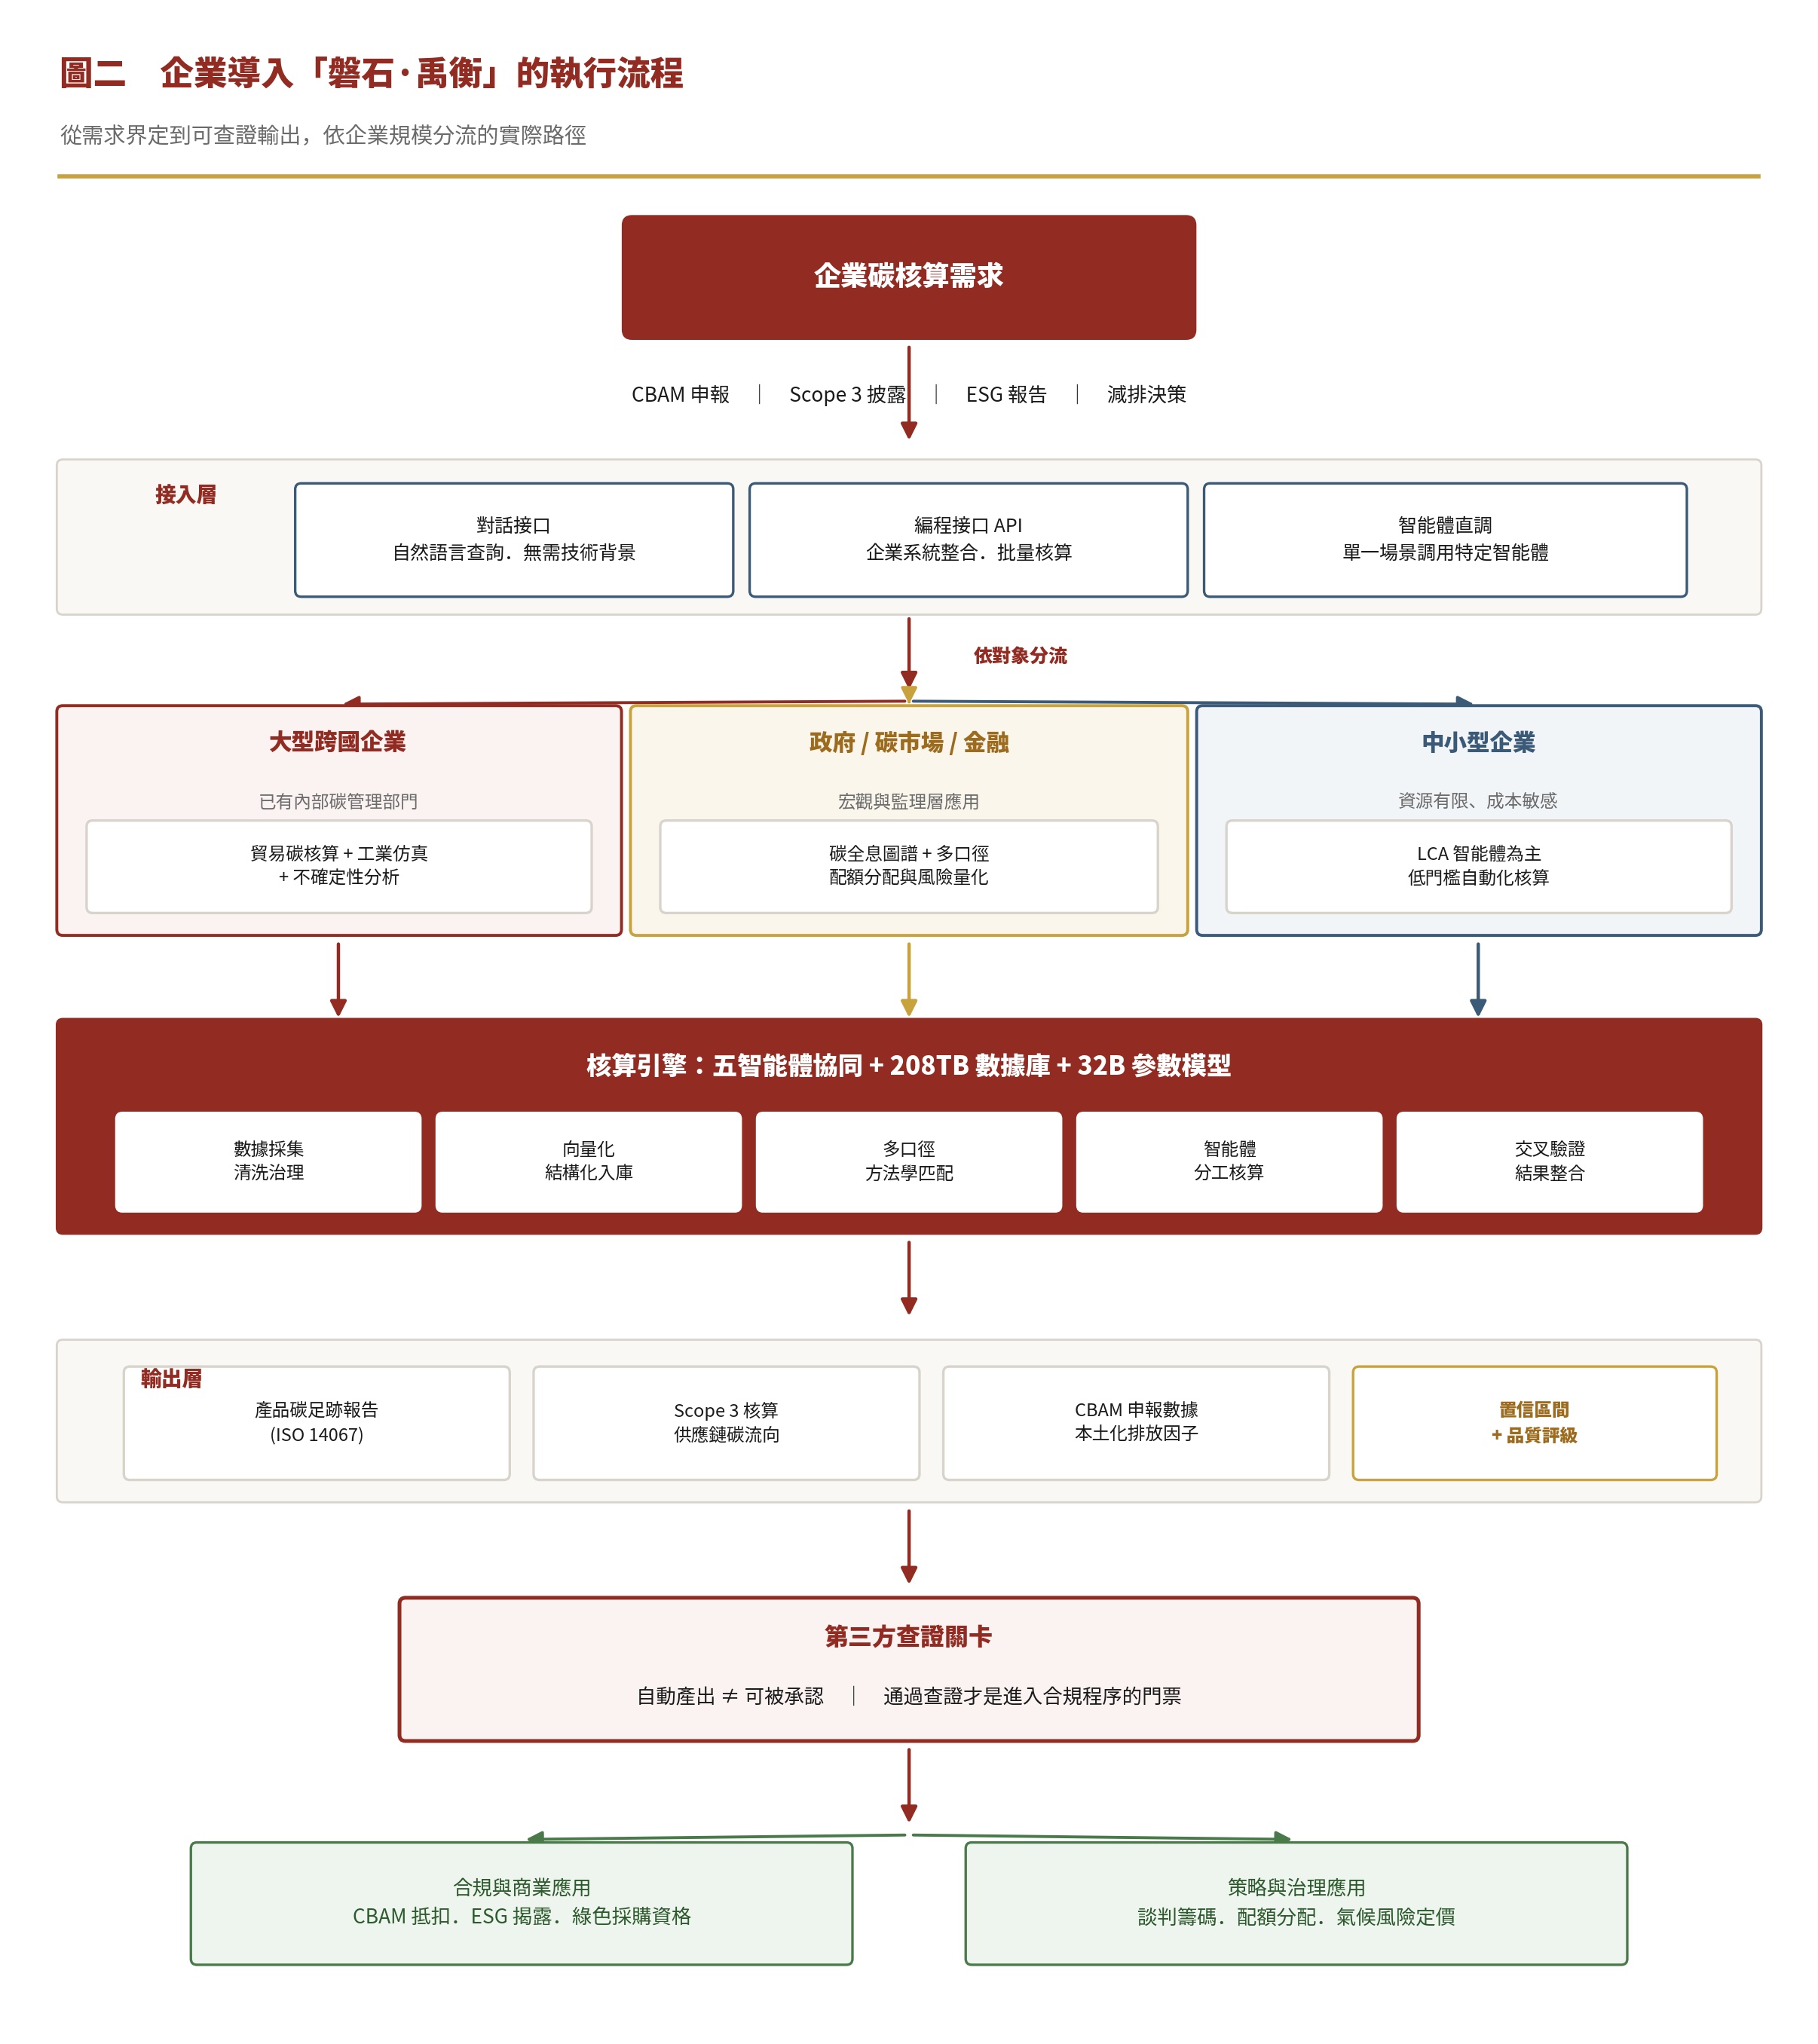
這張流程圖裡最該被注意的,是倒數第二層那道第三方查證關卡。禹衡能自動產出報告,但自動產出不等於能被承認。一份碳足跡報告要能用於 CBAM 抵扣、ESG 揭露或綠色採購資格審查,必須先通過具公信力的第三方查證。這道關卡最常被跳過。所有把 AI 碳核算講得無所不能的宣傳,都略過了它。而它恰恰是實務上決定這套工具到底有沒有用的分水嶺。
伍、關鍵數據及其方法學前提
禹衡發布時提出了一批具體數字。這些數字要能支撐論點,前提是理解它們各自的方法學基礎。以下把報告中的核心數據逐一列出,並附上判讀時必須留意的前提。
一、國別排放調整:17.7% 背後是口徑之爭
以2022年為例,在禹衡的新核算體系下,主要國家溫室氣體排放量相較於傳統 IPCC 生產端結果出現顯著調整。這組數字是整份報告最有政治重量的部分。但它有一個前提。它的成立完全建立在「改用消費端口徑」上,脫離這個前提,數字就失去意義。
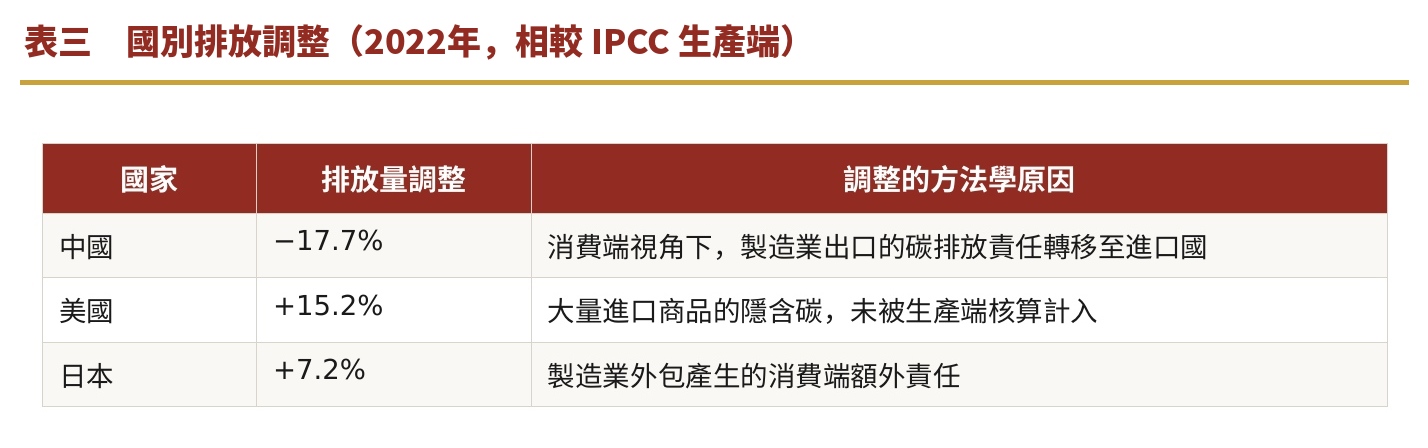
判讀這組數字的關鍵是:它們不是說中國的實際排放變少了,而是說如果改用「誰消費誰負責」的邏輯來記帳,責任的分配會這樣移動。生產端和消費端沒有哪一個絕對正確,它們回答的是不同的問題。禹衡的貢獻是讓兩種答案能並排呈現。爭議也在這裡。選擇哪一種口徑當基準,直接決定了誰的減排責任比較重,而這件事沒有純技術的答案。
二、綠色產品減排貢獻:1:175 這個比例怎麼來的
2024年中國出口的風機和光伏產品,生產階段產生約200萬噸碳排放,運行階段為全球貢獻了約3.5億噸碳減排收益,比例高達1:175。這個數字的方法學前提是全生命週期視角。在生產端框架下,只看得到那200萬噸排放。看不到的是產品在使用年限內因為替代化石能源而避免掉的那3.5億噸。這正是禹衡想凸顯的框架盲點:一個只算生產、不算使用效益的體系,會把綠色產品的製造國記成排放者,而看不見它同時是減排的貢獻者。這個論點在方法學上站得住腳,但要注意3.5億噸是運行階段的累計推估,涉及產品壽命、發電替代基準等假設,屬於情境估算,不是實測值。
三、CBAM 默認值偏差:20 倍差距的實務意義
禹衡發現,CBAM 的默認排放因子系統性地高估了中國產品的排放因子。以鋼鐵品項為例,採用本土化排放因子與直接套用 CBAM 默認值,兩種計算路徑下的應付碳稅金額差距懸殊,在某些品項下倍數差距可超過20倍。這個差距不是邊際調整。它直接決定一家出口商的成本結構,甚至決定某些品項還值不值得繼續出口到歐盟。這裡要補充一個報告未展開、但對台灣與中國出口商同等重要的技術細節:CBAM 的計算本身還有簡化係數法與 FAA 基準法(依 IR 2025/2620)兩種路徑,兩者算出的應課徵嵌入排放量差異極大,方法選擇本身就是企業必須管理的變數。禹衡的本土化因子庫,正是對這種預設偏高的直接回應,但能不能被歐盟承認,仍取決於查證程序,因子庫本身做不到這件事。
四、技術規格數字:208TB 與 32B 的意義與限制
208TB 多格式碳數據與320億參數的垂直領域模型,是禹衡的兩個核心規格。判讀這兩個數字要避免一個常見誤解:規模不等於準確。這是兩回事。208TB 說明的是數據覆蓋的廣度與治理的工程量,320億參數說明的是模型的推理能力上限,但核算結果準不準,取決於底層排放因子的品質與方法學的正確性,而不是參數多寡。這也是為什麼不確定性分析智能體的存在如此重要,它是唯一能告訴使用者「這個數字可信度多高」的機制。
陸、與現存主流碳核算體系的深度比較
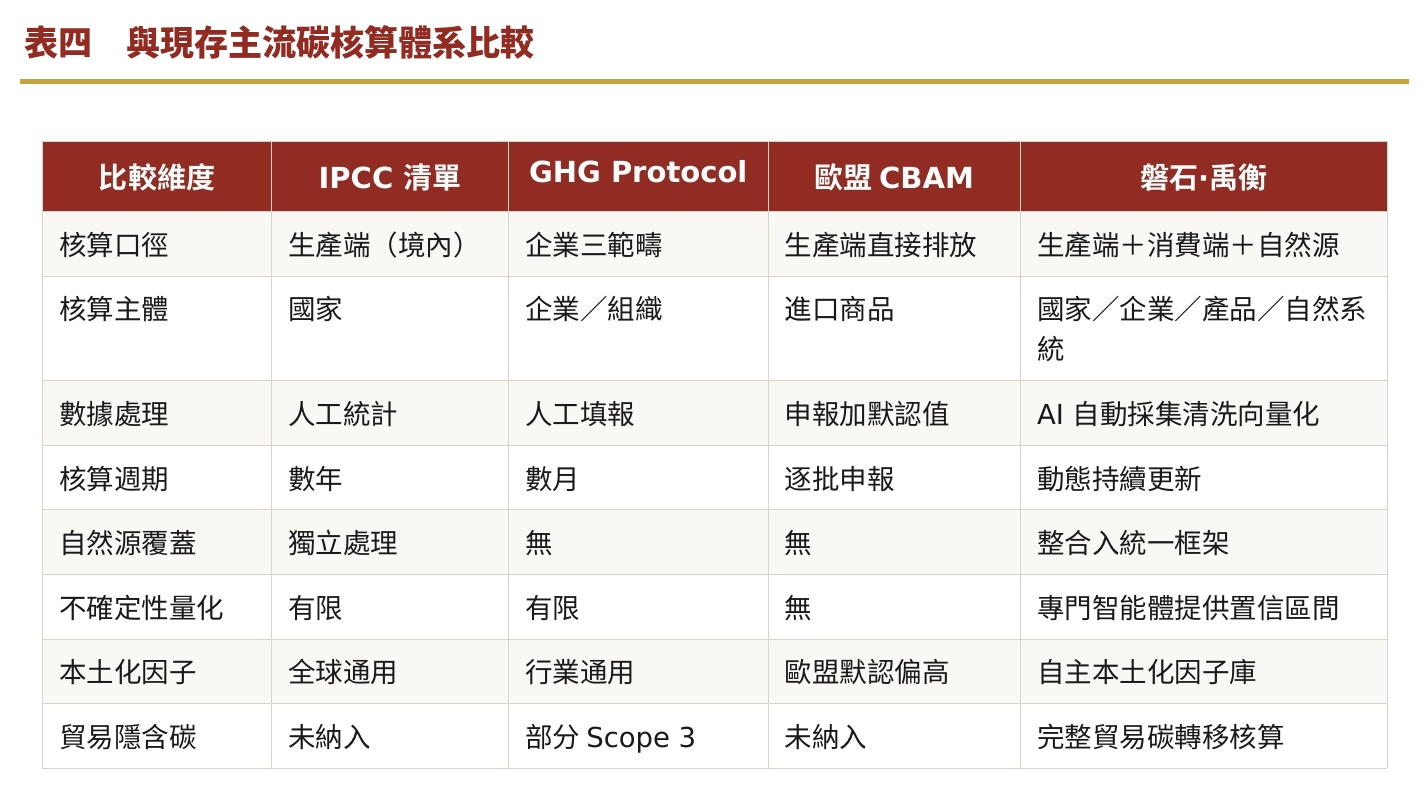
要判斷禹衡的定位,必須把它放進現存的方法學版圖裡。全球碳核算目前由三大體系主導,各自服務不同對象、各自有明確的方法學缺口。
- IPCC 國家溫室氣體清單指南:國家層級履約的基礎框架,以生產端境內排放為核算邊界,服務對象是締約國政府。
- GHG Protocol:全球應用最廣的企業碳核算標準,將排放分為 Scope 1 直接排放、Scope 2 外購電力、Scope 3 供應鏈間接排放,服務對象是企業組織。
- 歐盟 CBAM 碳邊境調節機制:貿易碳關稅機制,申報人若無實測數據,默認採用歐盟同類產品中排放最差10%設施的平均值。
一、GHG Protocol 的彈性,同時是它的弱點
GHG Protocol 的設計初衷是發揮指導作用,本來就不打算強制約束,這給了企業必要的操作彈性,但也留下了漏洞。大型跨國公司可以利用規則的靈活性,在邊界設定、排放因子選取上做對自己有利的選擇,使得不同公司的數據實質上不具可比性。禹衡的多智能體架構採用統一方法學強制執行,理論上從制度設計上壓縮了選擇性核算的空間。但這裡有個張力值得指出:強制統一方法學提升了可比性,卻也犧牲了 GHG Protocol 刻意保留的彈性,而那份彈性在面對千差萬別的產業實況時,有時是必要的。
二、CBAM 默認值的系統性偏差,是設計選擇不是技術缺陷
CBAM 規定無法提供可靠數據時,默認值採歐盟該類產品中性能最差10%設施的平均排放強度。要公允地說,這不是 CBAM 的技術失誤,而是刻意的政策設計,目的是用懲罰性默認值逼出真實數據申報。問題是這個設計的成本分配不對稱,有能力舉證的大企業可以避開,無力舉證的中小出口商只能承受。禹衡自主構建的本土化因子庫,是對這種技術性不公平的直接回應,讓被高估的出口商有了申訴的科學依據。
三、傳統 LCA 的人工瓶頸,是成本問題也是普及障礙
傳統排放因子法受技術水平、工藝過程影響,不確定性較大;物料衡算法雖然科學,但工作量大、需要詳細的生產過程數據、適用範圍受限。兩種傳統方法的共同問題是都極度依賴人力,這讓完整的 LCA 成為一件昂貴的事。禹衡的 LCA 智能體把這個需要專業工程師數週的流程自動化,真正的意義不只是替大企業省錢,而是可能讓碳足跡核算從大企業的合規動作,變成中小企業負擔得起的標配工具。前提,仍然是自動產出能通過查證。
柒、適用對象與差異化應用
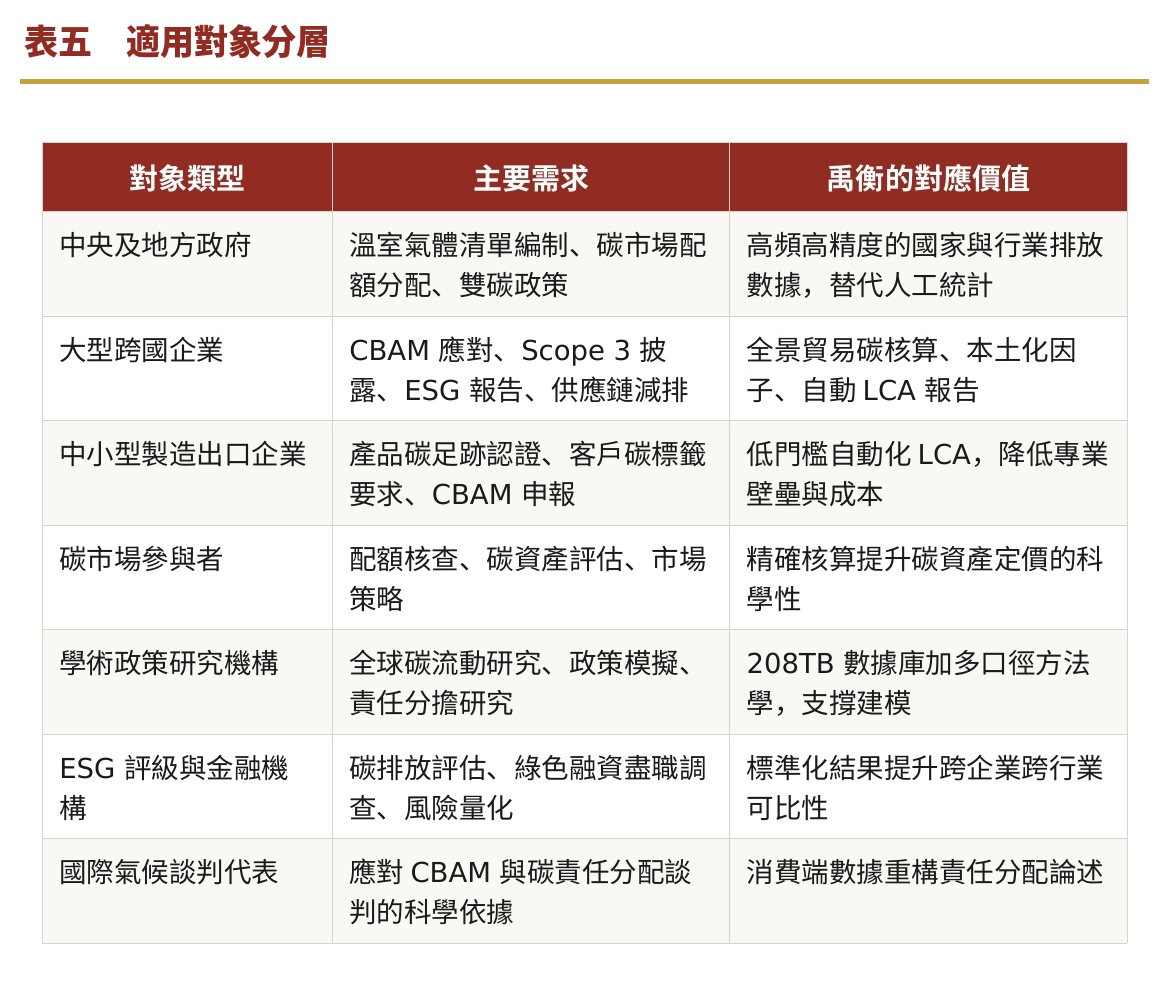
禹衡的應用場景橫跨政府、學術、企業與金融機構。不同對象因為需求、資源、能力不同,用到的智能體與獲得的價值也完全不同。以下依主要對象分層說明。
捌、使用後的效應:大型企業與中小企業的分野
禹衡對不同規模企業產生的效應,截然不同卻互補。同一套工具,在資源充足的跨國企業手上是策略武器,在資源有限的中小企業手上是生存工具。以下分別深入。
一、具有跨國供應鏈的大型企業
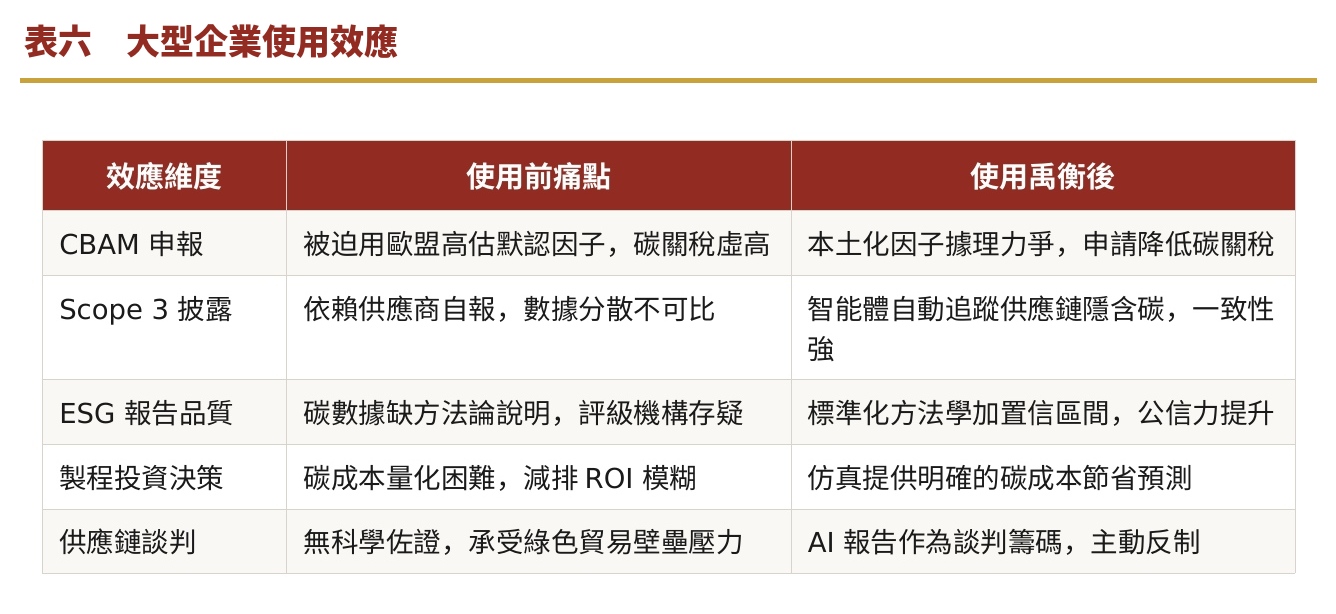
大型企業通常已有內部碳管理部門,有能力建構本土化數據並完成查證程序,因此他們用到的是禹衡最複雜的幾個智能體。第一,把 CBAM 從被動成本變成可管理的策略變數:過去無法提供本土數據就只能被動接受歐盟最差10%設施的默認因子,現在可透過 LCA 智能體生成符合國際標準的本土化報告,向 CBAM 申報機構申請適用實際排放因子。第二,Scope 3 供應鏈排放的系統性可視化:貿易碳核算智能體直接追蹤供應鏈各節點隱含碳,企業不需逐一向供應商索取數據,就能獲得有科學基礎的 Scope 3 結果,大幅提升 GRI、CSRD 等 ESG 報告的可信度。第三,工業製程的前瞻性碳優化:仿真智能體讓鋼鐵、水泥企業在評估電弧爐替換高爐之前,就能量化碳成本節省,為投資委員會提供決策依據。第四,強化談判話語權:附有置信區間認定的碳足跡報告,在面對歐美買家的供應鏈盡職調查時,比傳統人工核算更站得住腳。
二、中小型企業
中小企業面對的問題更直接,也更關乎生存。第一,打破碳核算的專業壁壘:傳統完整 LCA 需委外顧問、耗時數週、成本高昂,中小企業幾乎無力負擔,禹衡的 LCA 智能體讓企業只需輸入基本產品資訊,就能獲得符合 ISO 14067 的碳足跡報告,把時間成本從數週壓縮到數小時。第二,回應大客戶的供應鏈碳透明化要求:當 Apple、IKEA、Nike 這類品牌商要求供應商提交碳足跡或碳標籤時,缺乏工具的中小製造商面臨失去訂單的風險,禹衡讓他們能低成本快速出具證明,鞏固供應鏈地位。第三,CBAM 申報的低門檻路徑:出口歐盟的鋼鐵配件、鋁製品、化工原料製造商,無需聘請昂貴顧問就能自主生成申報所需的排放核算,並以本土化因子替代歐盟默認值。第四,識別高碳環節輔助精準投資:資源有限的中小企業無法全面減排,仿真與 LCA 智能體能標示產品生命週期中碳排最高的環節,讓有限的綠色投資花在刀口上。
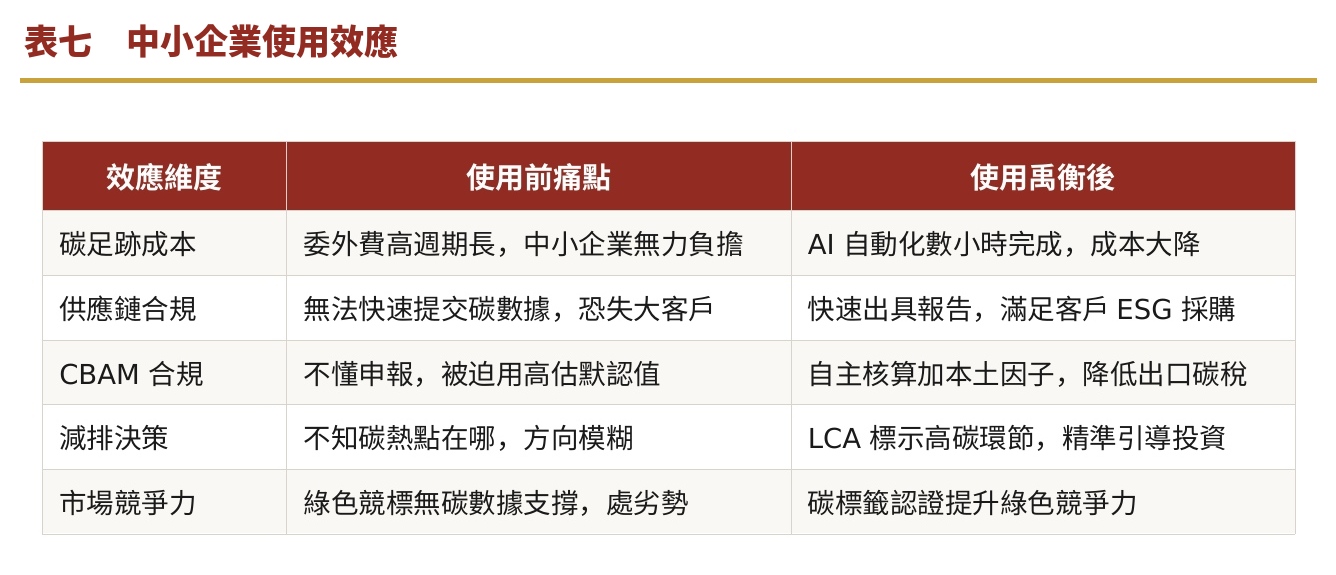
三、兩者對比:同一工具的兩種角色
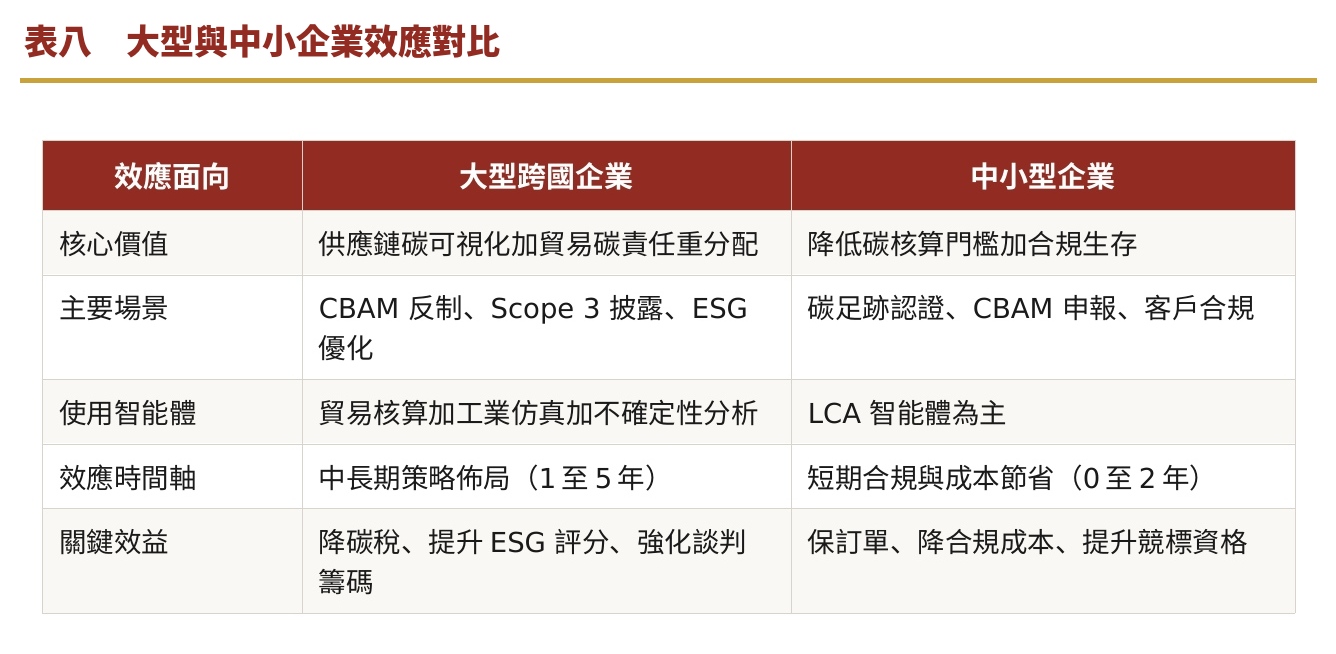
玖、對國際格局的影響與待解的挑戰
一、重塑國際氣候談判的話語權
過去中國在氣候談判中長期處於用別人的尺子量自己的被動局面。禹衡提供了一套中國主導、科學論證的替代數據體系,在兩個議題上獲得科學武器。碳排放責任重分配上,2022年中國調整−17.7%、美國調整+15.2%,若被國際社會接受,將從根本上改變各國歷史減排責任的認定基礎。綠色出口貢獻量化上,光伏與風機產品的全球減排貢獻有了具體數字,可成為爭取氣候貢獻認定的核心論據。
二、對 CBAM 碳關稅的分階段衝擊
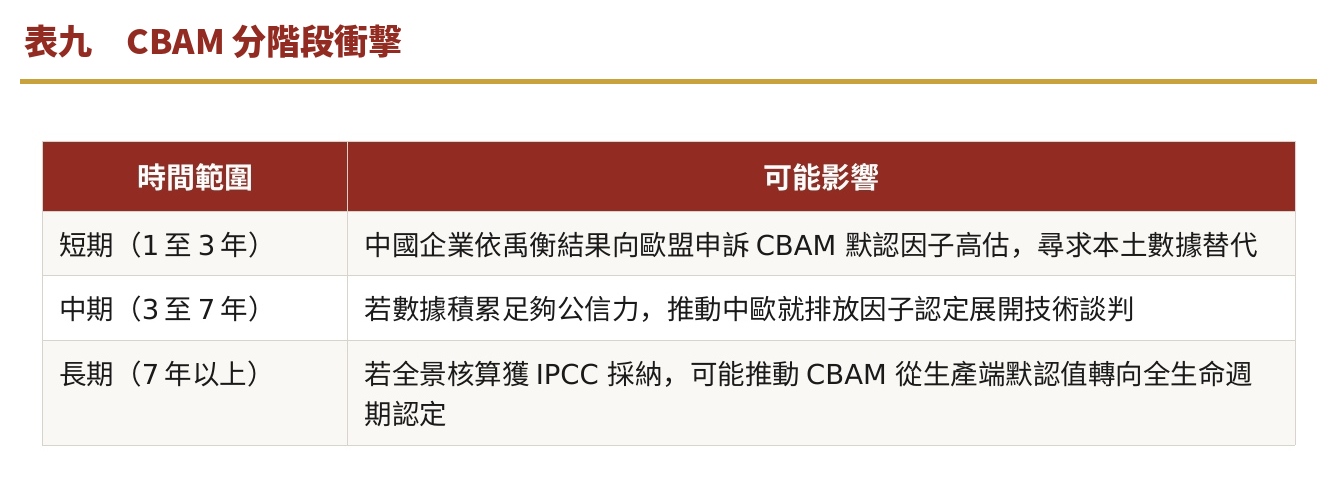
三、三個無法迴避的挑戰
禹衡要在國際碳治理中取得份量,有三道關卡繞不過去。第一是科學公信力的建立需要時間。禹衡的結論對中國有利,這個利益與結論方向一致的事實本身,就會讓國際社會提高審查標準,方法學再嚴謹也無法自動消除質疑。第二是方法論分歧的政治化風險。消費端與生產端核算是學術界長期爭論的議題,兩種口徑各有其合理性,一旦口徑選擇被外界看成政治操作,不再被當成科學判斷,反而會削弱這套系統的話語權。第三是數據共享的對等性困境。全景式核算需要各國的貿易、能源、工業數據深度共享,而各國對數據主權的保護意識日益增強,跨國數據獲取的壁壘可能成為模型精度的天花板。
拾、結論:一把新尺子的公信力,要靠別人來確認
回到開頭那三個數字。中國−17.7%、美國+15.2%、日本+7.2%,它們揭示的重點不在誰算錯,而在碳核算這件事從來沒有一個中立的原點。核算邊界怎麼畫,決定了責任怎麼分,而這個選擇過去被生產端口徑壟斷了三十年。禹衡的技術突破,是第一次讓多種口徑能夠並排計算、互相校驗,把一個被隱藏的預設,攤開成一個可以被討論、被選擇的變數。
但技術突破是一回事,被國際社會接受是另一回事。禹衡要在國際氣候治理的討論中取得真正的份量,路徑只有一條,就是讓方法學開放給外部機構驗證,讓數據集可以被獨立研究者重複使用,讓核算結果能夠接受與 IPCC 框架並排的直接比較與挑戰。這不是公關工程,是科學程序。一把新的尺子,不會因為製造它的人宣稱它更準就變準,它要等別人拿它量過同一個東西、得到一致的結果,公信力才算真正建立。
對台灣的企業與政策制定者而言,禹衡的意義不在選邊站。它預示的是一個方向:碳核算的方法學競爭已經開始,未來 CBAM 抵扣、供應鏈盡職調查、ESG 揭露所依據的排放數字,會越來越取決於用哪一套方法學、哪一批因子算出來的。看懂這場方法學之爭,比接受任何單一結論都重要。這是這份報告想留下的判斷。
參考資料
- 中國科學院. (2026, 4月9日). 中國發布全球首個全景式碳排放核算大模型 精準服務應對氣候變化. 中國科學院. https://www.cas.cn/cm/202604/t20260409_5106337.shtml
- 中國科學院上海高等研究院. (2026, 4月8日). 磐石·禹衡碳核算大模型(1.0版)[大型語言模型]. 中國科學院上海高等研究院.
- 國家能源局. (2026, 4月10日). 我國發布全球首個全景式碳排放核算系統. 國家能源局. https://www.nea.gov.cn/20260410/d5a2ddf7e0df4d628be6cdb7c514eb31/c.html
- European Commission. (2023). Regulation (EU) 2023/956 of the European Parliament and of the Council of 10 May 2023 establishing a carbon border adjustment mechanism. Official Journal of the European Union, L 130, 52–104. http://data.europa.eu/eli/reg/2023/956/oj
- European Commission. (2025). Commission Implementing Regulation (EU) 2025/2620 laying down rules for the application of Regulation (EU) 2023/956 as regards the determination of embedded emissions. Official Journal of the European Union.
- Intergovernmental Panel on Climate Change. (2006). 2006 IPCC guidelines for national greenhouse gas inventories (H. S. Eggleston, L. Buendia, K. Miwa, T. Ngara, & K. Tanabe, Eds.). Institute for Global Environmental Strategies.
- Intergovernmental Panel on Climate Change. (2019). 2019 refinement to the 2006 IPCC guidelines for national greenhouse gas inventories. IPCC.
- International Organization for Standardization. (2018). Greenhouse gases — Part 1: Specification with guidance at the organization level for quantification and reporting of greenhouse gas emissions and removals (ISO 14064-1:2018). ISO.
- International Organization for Standardization. (2018). Greenhouse gases — Carbon footprint of products — Requirements and guidelines for quantification (ISO 14067:2018). ISO.
- World Resources Institute, & World Business Council for Sustainable Development. (2004). The greenhouse gas protocol: A corporate accounting and reporting standard (Rev. ed.). WRI & WBCSD.
磐石禹衡 · 碳核算方法學 · 消費端核算 · CBAM · 排放因子 · Scope 3 · 生命週期評價 · IPCC 清單指南 · GHG Protocol · 碳責任分配